צוות תביעות מקבל 8,000 מסמכים בשבוע. חלקם קובצי PDF נקיים שהופקו מפורטל. אחרים הם טפסים מצולמים, חשבוניות מרובות עמודים, הערות בכתב יד וקבצים מצורפים לאימייל עם שמות לא עקביים. ההחלטה האמיתית בין AI OCR לעיבוד ידני אינה האם תוכנה יודעת לקרוא טקסט. השאלה היא האם הארגון שלכם יכול להפוך מסמכים נכנסים לנתונים אמינים ושמישים, בלי ליצור תור חריגים גדול יותר או בעיית ציות.
עיבוד ידני יכול להיראות אמין, כי אנשים מזהים הקשר, פותרים עמימות ומפעילים שיקול דעת. אבל ככל שהנפח גדל, הוא נעשה יקר וקשה לבקרה. AI OCR יכול לצמצם דרמטית עבודה חוזרת, אבל רק כשהוא מתוכנן כחלק מתהליך עבודה שכולל אימות, ניתוב, אינטגרציה למערכות ובדיקה אנושית במקומות הנדרשים.
ברוב העסקים בעלי תפעול מורכב, התשובה הנכונה איננה החלטת החלפה פשטנית. מדובר בתהליך עבודה בפרודקשן שמקצה את החילוץ השגרתי ל-AI ומפנה מקרים לא ודאיים או בסיכון גבוה לעובדים מוסמכים.
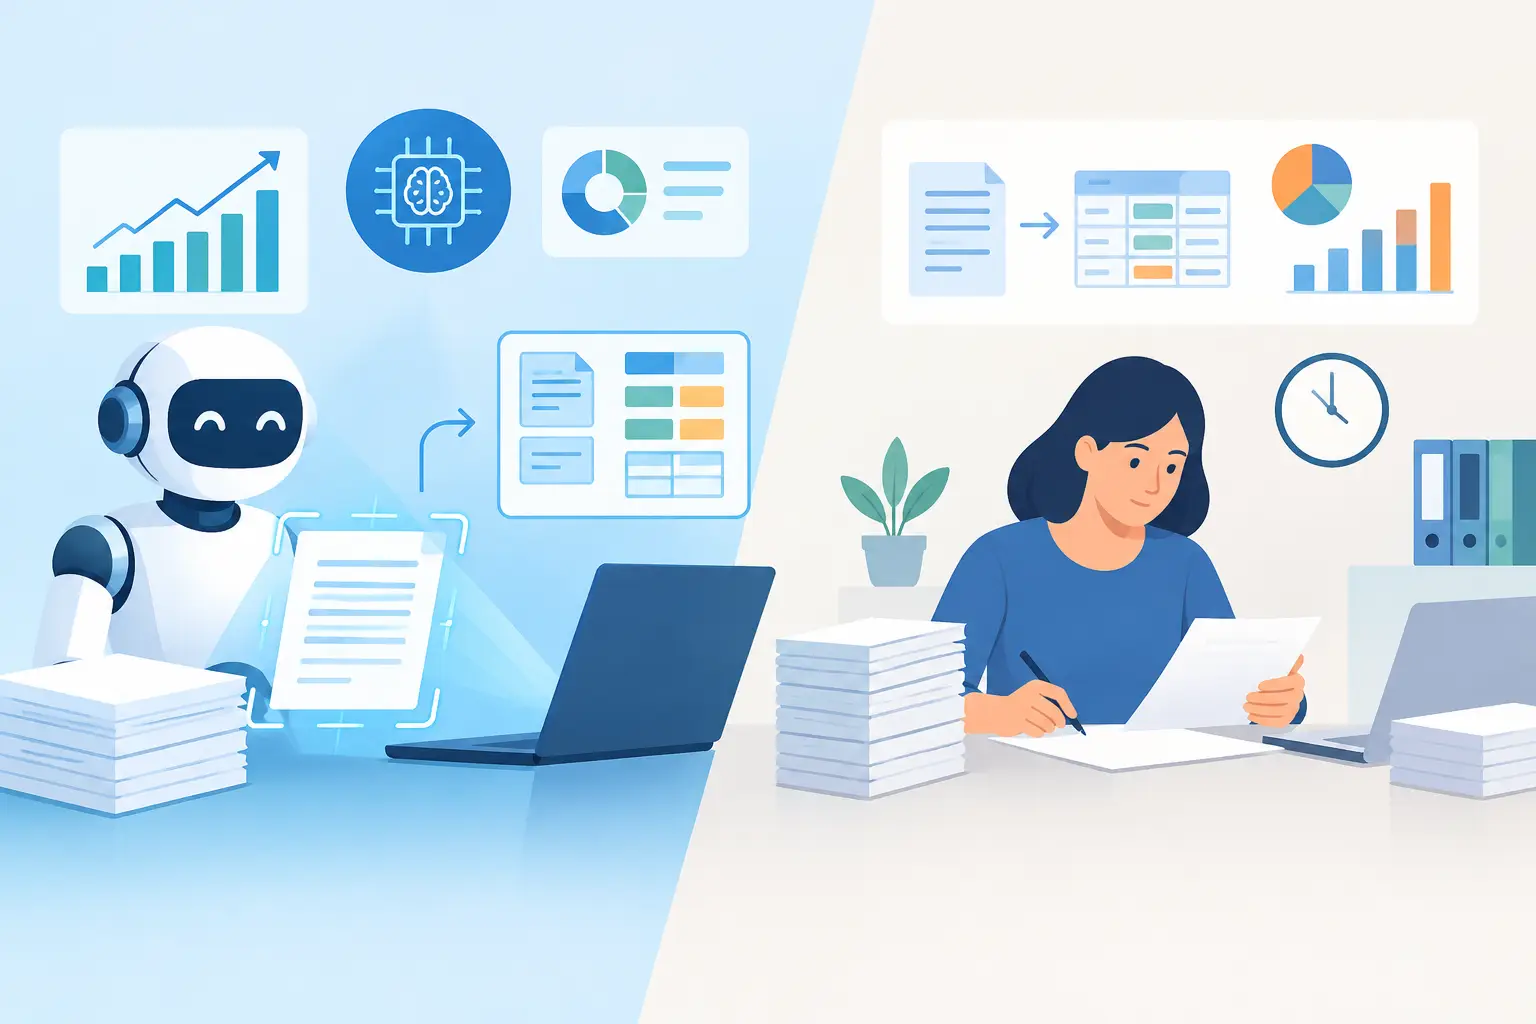
AI OCR מול עיבוד ידני: ההבדל התפעולי
עיבוד ידני מתנהל בדרך כלל ברצף מוכר: עובד פותח קובץ, מזהה את סוג המסמך, קורא את השדות הרלוונטיים, מזין נתונים ל-CRM, ל-ERP, למערכת התביעות או לגיליון אלקטרוני, ובודק את התוצאה מול מדיניות או כללים עסקיים. התהליך גמיש, אבל הוא תלוי בזמינות הצוות, באיכות ההכשרה ובביצוע עקבי.
AI OCR משנה את הרצף. מסמך נכנס דרך אימייל, פורטל לקוחות, אחסון קבצים או API. המערכת מסווגת אותו, מחלצת את הטקסט והשדות הרלוונטיים, מאמתת ערכים ושולחת נתונים מובנים למערכות ההמשך. רשומות שעומדות בספי הביטחון ובכללים העסקיים יכולות להמשיך אוטומטית. רשומות שנכשלות מנותבות לתור בדיקה, כשהמסמך המקורי והשדות המסומנים גלויים לבודק.
ההבחנה הזו חשובה. OCR לבדו אינו פתרון תפעולי. קריאת "סך החשבונית" מתוך PDF לא מאשרת שהסכום תואם להזמנת רכש, שייך לספק מאושר, נקוב במטבע הנכון או אמור להירשם במרכז עלות מסוים. הטמעה שעובדת משלבת בינה מסמכית עם לוגיקת תהליך עבודה.
איפה לעיבוד ידני עדיין יש יתרון
בדיקה אנושית נשארת האפשרות הטובה יותר לעבודה בנפח נמוך, למסמכים משתנים מאוד ולהחלטות שדורשות פרשנות ולא רק חילוץ. הסכם משפטי עם סעיפים חריגים, תיאור רפואי או בקשת חיתום עם ראיות חסרות עשויים לדרוש שיקול דעת מנוסה שאין להעביר לאוטומציה.
עיבוד ידני הגיוני גם כשהתהליך עצמו משתנה מדי שבוע. אוטומציה מוקדמת מדי של תהליך לא יציב עלולה לקודד בלבול לתוך התוכנה. במקרה כזה, מיפוי התהליך הנוכחי, הגדרת הנתונים הנדרשים ותקנון קליטת המסמכים עשויים להניב יותר ערך לפני שמתחילים בפיתוח AI.
המחיר הוא שעבודה ידנית נושאת עלות תפעולית נסתרת. מנהלים מודדים לעיתים קרובות שעות עבודה, אבל מפספסים עבודה חוזרת, עיכובים באישורים, דגימות איכות, תחלופת עובדים, הכשרה, ניהול צבר משימות ואת העלות של רשומות שהוזנו באופן לא עקבי במערכות שונות. תהליך שעובד ב-200 מסמכים בחודש עלול לקרוס במהירות ב-20,000.
במה AI OCR טוב - ואיפה הוא נכשל
AI OCR מודרני יעיל בחילוץ נתונים ממסמכים חצי-מובנים ולא מובנים, כולל חשבוניות, בקשות, שטרי מטען, טפסי מס, תעודות מזהות והתכתבויות. הוא יכול לסווג מסמכים, ללכוד צמדי מפתח-ערך, לזהות טבלאות ולהשתמש בהקשר הסובב כדי להבחין בין כתובת לחיוב לכתובת למשלוח.
זה בעל ערך מיוחד כשצוותים מטפלים שוב ושוב באותן קטגוריות מסמכים, אבל מקבלים אותם ממקורות ובפריסות רבים. במקום לבנות תבנית נוקשה לכל חשבונית ספק, שכבת חילוץ מבוססת AI יכולה להכליל על פני וריאציות נפוצות. כך מצטמצם מאמץ ההקמה ומשתפר הכיסוי כשמגיעים פורמטים חדשים.
עם זאת, AI OCR לא מבטל את הצורך בבקרות. סריקות באיכות נמוכה, כתב יד, פריסות חריגות, עמודים חסרים, ערכים סותרים וסוגי מסמכים לא מוכרים עלולים לפגוע בדיוק. כך גם תוויות שמופיעות בכמה מקומות, כמו כמה תאריכים או סכומים במסמך אחד.
מערכת ברמת פרודקשן מתייחסת לאי-ודאות כאל אירוע בתהליך העבודה, לא כאל מבוכה. היא מתעדת את רמת הביטחון בחילוץ, מפעילה כללי אימות דטרמיניסטיים ושומרת נתיב ביקורת מהשדה המובנה ועד לעמוד המקור. בודק צריך להיות מסוגל לראות למה פריט סומן ולתקן אותו בלי להקליד מחדש את כל המסמך.
השוו עלות לפי תפוקה, חריגים וסיכון
השוואת העלויות היא רק לעיתים רחוקות "מנוי לתוכנה מול שכר עובד". לעיבוד ידני יש עלות משתנה ברובה: יותר מסמכים דורשים בדרך כלל יותר שעות. ל-AI OCR יש עלויות הטמעה, אינטגרציה, ניטור ושימוש, אבל ברגע שהוא פועל באופן אמין הוא יכול לעבד נפח שגרתי בעלות שולית נמוכה בהרבה.
המקרה העסקי מתחזק כשצוות מקדיש זמן משמעותי לחילוץ חוזר, נפחי המסמכים צפויים או גדלים, והנתונים צריכים להיות מוזנים ליותר ממערכת אחת. הוא מתחזק גם כשטיפול איטי יוצר עלויות בהמשך השרשרת, כמו עיכוב בקליטת לקוחות, החמצת תנאי תשלום, יישוב תביעות איטי יותר או זמני תגובה גרועים ללקוחות.
שיעורי החריגים הם המדד המרכזי. אם אפשר לחלץ, לאמת ולרשום אוטומטית 90% מהמסמכים השגרתיים, 10% הנותרים יכולים לקבל תשומת לב אנושית ממוקדת. אם מחצית מכל המסמכים דורשים בדיקה מקיפה, הבעיה עשויה להיות איכות קלט ירודה, דרישות נתונים לא ברורות, לוגיקת אימות לא מספקת או קטגוריית מסמכים שעדיין אינה מתאימה לאוטומציה.
גם הסיכון משנה את החישוב. בפיננסים, בביטוח, בבריאות ובתפעול מפוקח, שדה שגוי עלול לעלות יותר משדה שמתעכב. זה לא מעדיף אוטומטית עבודה ידנית, כי גם הזנה ידנית מייצרת שגיאות. המשמעות היא שהאוטומציה חייבת להשתמש בספי האישור הנכונים, בהפרדת סמכויות, בתיעוד, במדיניות שמירת נתונים ובטיפול בחריגים המתאימים לתהליך.
הארכיטקטורה שמאחורי אוטומציית מסמכים אמינה
תוכניות ה-AI OCR החזקות ביותר מתחילות בתהליך עבודה צר ומדיד, ולא בהבטחה רחבה לאוטומציה של כל המסמכים. חברה יכולה להתחיל בחשבוניות ספקים של יחידה עסקית מוגדרת, בקליטת בקשות הלוואה או בחילוץ קריאות שירות מקובצי PDF שנשלחו באימייל.
קודם כול, הגדירו את המסמכים, שדות היעד, שיעורי השגיאה המקובלים, ציפיות זמן הטיפול והאחראים על החריגים. אחר כך זהו את מערכות הרשומה. אם הנתונים המחולצים נוחתים בגיליון אלקטרוני לפני שמישהו מזין אותם מחדש ל-ERP, תהליך העבודה לא פתר את בעיית הליבה.
ארכיטקטורה טיפוסית כוללת שכבת קליטה, אחסון מסמכים, שירותי סיווג וחילוץ, אימות כללים עסקיים, ממשק לבדיקה אנושית ומחברים למערכות התפעוליות. הסטאק המדויק תלוי בדרישות האבטחה ובפלטפורמות הקיימות, אבל לכל רכיב יש תפקיד ברור.
האימות ראוי לתשומת לב מיוחדת. הוא צריך לכלול בדיקות כמו שדות חובה, פורמטים של תאריכים, זיהוי חשבוניות כפולות, חישובי מס, התאמת ספקים, מגבלות מדיניות והצלבות מול נתוני אב. ה-AI יכול לפרש את המסמך; הכללים והמערכות המחוברות קובעים אם התוצאה המחולצת קבילה לשלב הבא.
בדיקה אנושית בתוך הלולאה (human-in-the-loop) צריכה להיות מתוכננת למהירות. הבודקים צריכים גישה זה לצד זה לקובץ המקורי, לערכים המחולצים, לאותות הביטחון ולהקשר הרלוונטי של החשבון או התיק. התיקונים שלהם צריכים להזין את עבודת הניטור והשיפור, ולא להיעלם בתור שאיש לא מודד.
אבטחה וציות הם דרישות הטמעה
תהליכי עבודה של מסמכים מכילים לעיתים קרובות מידע אישי, פרטים פיננסיים, נתוני בריאות, חוזים ורשומות תפעול פנימיות. שליחת קבצים לשירות OCR בלי לוודא את אופן הטיפול בנתונים, בקרות הגישה, נוהלי השמירה והדרישות החוזיות יוצרת חשיפה מיותרת.
ההטמעה צריכה להגדיר מי יכול להגיש מסמכים, מי יכול לצפות בקובצי המקור, מי יכול לאשר תיקונים ואילו מערכות מקבלות את הנתונים שנוצרו. הצפנה, גישה מבוססת תפקידים, תיעוד ביקורת, הפרדת סביבות ובקרות שמירה צריכים להיות מתוכננים לפני הפריסה, ולא להתווסף אחרי שפיילוט מגיע לפרודקשן.
בתהליכים רגישים לציות, ארגונים צריכים גם תיעוד שאפשר לעמוד מאחוריו: מה חולץ, איזה אימות בוצע, האם אדם התערב ואיזו גרסה של תהליך העבודה קיבלה את ההחלטה. כאן דמו AI גנריים נעצרים לעיתים קרובות. הדרישה התפעולית היא עקיבות.
איך להחליט מאיפה להתחיל
בחרו תהליך עם נפח מספיק כדי שיהיה משמעותי, קלטים ופלטים ברורים ונקודת כאב תפעולית גלויה. מקרי השימוש הראשונים הטובים ביותר הם בדרך כלל חוזרים אבל לא טריוויאליים: יש להם זמן טיפול מדיד, שדות נתונים משותפים ופעולת המשך מוגדרת.
קבעו קו בסיס לפני הפיתוח. מדדו את נפח המסמכים הנוכחי, זמן הטיפול הממוצע, שיעורי השגיאות והעבודה החוזרת, זמן הטיפול הכולל, גיל הצבר ומספר העובדים המעורבים. אחר כך הגדירו הצלחה במונחים עסקיים, כמו צמצום של 60% בנגיעות ידניות, קיצור זמן הקליטה מיומיים לשעתיים או שיפור שלמות הנתונים לפני שהרשומות מגיעות לצוות התפעול.
פיילוט צריך לבחון מסמכים מייצגים, כולל סריקות גרועות ומקרי קצה, ולא רק את הדוגמאות הנקיות ביותר. הוא צריך גם להוכיח את מסלול האינטגרציה, את חוויית הבדיקה ואת תהליך הניטור. Invatechs ניגשת לעבודה הזו כאל אתגר מחובר של אספקת תוכנה: איכות החילוץ חשובה, אבל כך גם ה-APIs, ה-QA, הבקרות ותוצאות תהליך העבודה שסביבה.
הצעד המעשי הבא הוא לקחת תהליך אחד עתיר מסמכים ולמפות את החריגים שלו. החריגים האלה חושפים מה צריך להישאר אצל אנשים, מה אפשר לאמת באמצעות כללים, ואיפה AI OCR יכול להסיר את העבודה החוזרת שמונעת מצוותים מיומנים לקדם את העסק.