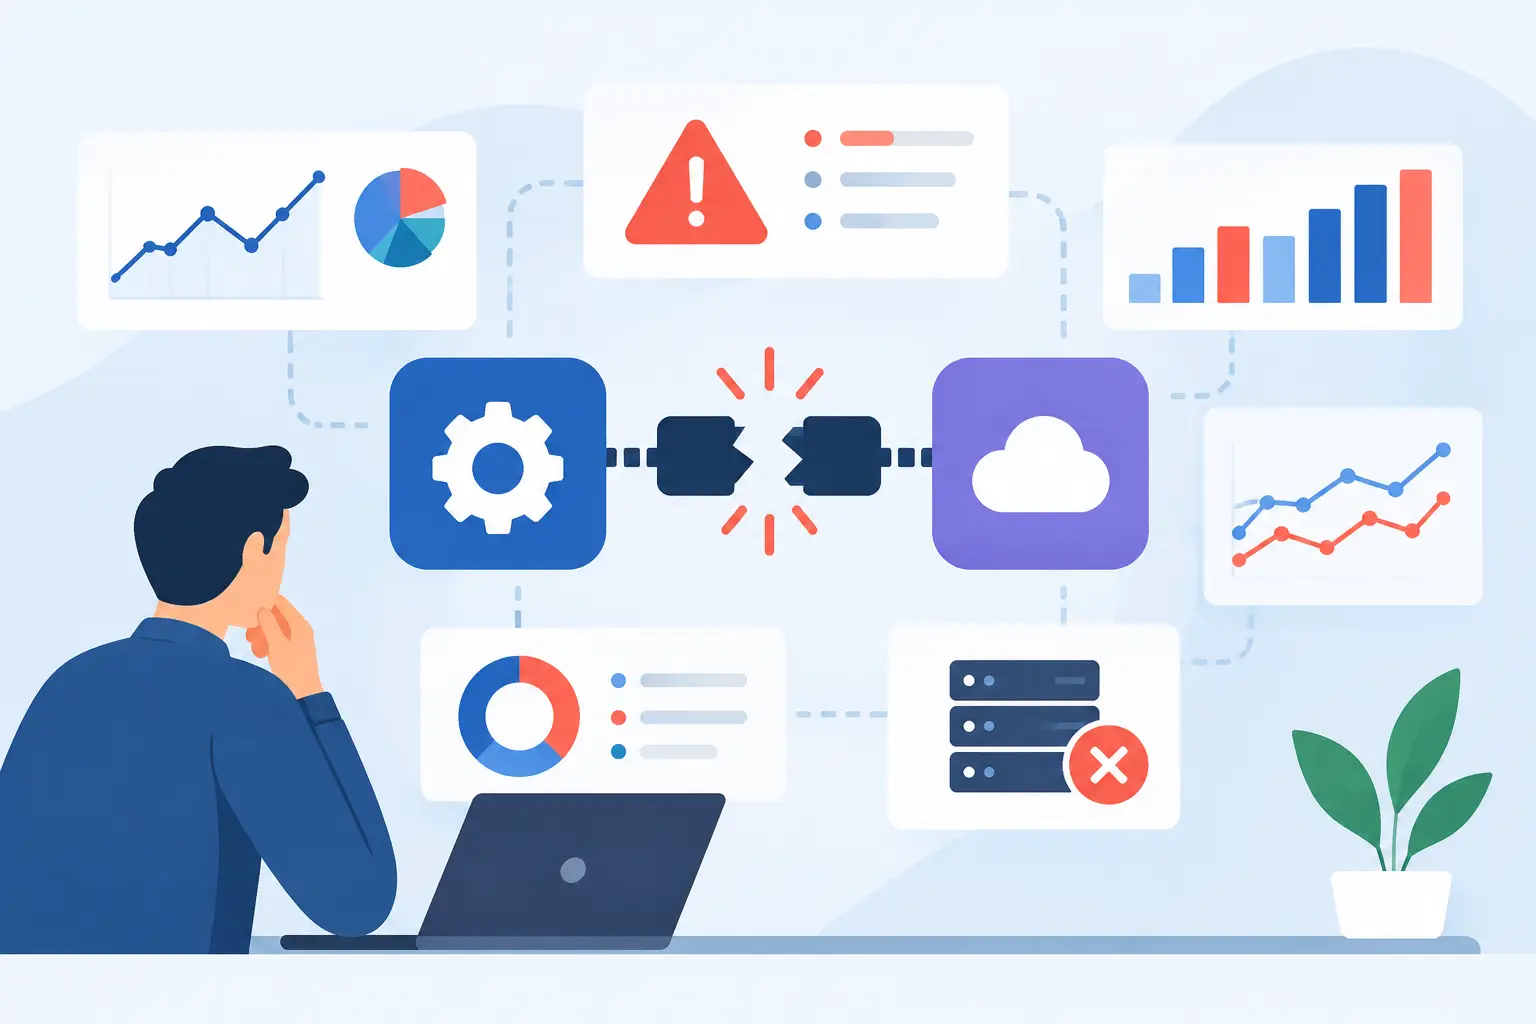
רשומת לקוח משתנה ב-CRM, אבל פלטפורמת החיוב עדיין מציגה את מנהל החשבון הקודם. הזמנה מסומנת כבוצעה במערכת אחת ונשארת פתוחה באחרת. נציג תמיכה רואה נתונים חלקיים, מקבל החלטה שגויה ויוצר עוד עבודת ניקוי. כך נראה הכישלון של אינטגרציות API באופן שהכי משנה: לא תמיד דרך השבתה דרמטית, אלא דרך שגיאות תפעוליות שקטות שמתפשטות בין מערכות מחוברות.
בעסקים בינוניים, אינטגרציות כבר אינן נוחות טכנית. הן נושאות נתוני הכנסות, סטטוס לקוחות, מלאי, אישורים, רשומות פיננסיות, ויותר ויותר גם החלטות שמונעות על ידי AI. כשאינטגרציה לא אמינה, העסק חוזר לבדיקות ידניות, לגיליונות אלקטרוניים, לתורי חריגים ולפתרונות עוקפים. היעילות שהובטחה נעלמת.
שורש הבעיה הוא כמעט אף פעם לא ש-API פשוט "לא עובד". רוב הכישלונות נובעים מהנחות חלשות לגבי נתונים, תהליכי עבודה, בעלות ותנאי פרודקשן. בניית מחבר היא משימה אחת. הפעלה של תהליך עסקי אמין על פני מערכות מרובות היא משימה אחרת.
למה אינטגרציות API נכשלות אחרי ההשקה?
אינטגרציה יכולה לעבור הדגמה, להשלים פיילוט ועדיין להיכשל בשימוש עסקי רגיל. סביבות בדיקה כמעט אף פעם לא משקפות את היקפי הפרודקשן, התנהגות משתמשים אמיתית, רשומות חלקיות, הבדלי הרשאות או שינויים בפלטפורמות צד שלישי. קריאת API מוצלחת מוכיחה קישוריות. היא לא מוכיחה שתהליך העבודה נכון, ניתן לשחזור, מאובטח או בר-תחזוקה.
דפוס הכישלון הנפוץ ביותר הוא פער בין המימוש הטכני למציאות התפעולית. צוות יכול למפות שדות נכון, אבל להתעלם ממה שאמור לקרות כשרשומה נערכת פעמיים, כשמערכת במורד הזרם אינה זמינה או כשעובד משנה סטטוס מחוץ לתהליך העבודה המתוכנן. מקרי הקצה האלה אינם נדירים בהיקפים גדולים. הם תנאי עבודה רגילים.
מודל הנתונים לא תואם את המודל העסקי
שתי מערכות יכולות להשתמש באותה תווית למושגים שונים. "לקוח" ב-CRM יכול לייצג ליד, חשבון פעיל או ארגון אם. ב-ERP, אותו לקוח עשוי להזדקק לישות משפטית, כתובת לחיוב, סטטוס מס, תנאי אשראי וקוד חשבון לפני שניתן ליצור אותו.
מיפוי שדות לבדו לא יכול לפתור את חוסר ההתאמה הזה. האינטגרציה צריכה כללים עסקיים מפורשים: איזו מערכת היא הסמכותית, מתי יש ליצור רשומה, אילו שינויים יכולים לזרום לכל כיוון ומה קורה כשהנתונים חלקיים. בלי ההחלטות האלה, צוותים יוצרים רשומות כפולות, דורסים מידע תקין או דוחפים נתונים לפני שהם מוכנים עבור המערכת המקבלת.
זה נעשה מורכב יותר כשמעורב AI. סוכן AI יכול לסווג פניית תמיכה, לחלץ נתונים ממסמך או להמליץ על פעולה. לפני שהפלט הזה מגיע ל-CRM, לפלטפורמת תביעות או למערכת כספים, הוא צריך כללי אימות, ספי ביטחון, מסלולי אישור ותיעוד ביקורת ברור. אוטומציה צריכה להפחית סיכון תפעולי, לא להעביר אותו הלאה במהירות של מכונה.
הבעלות לא ברורה בין מערכות וצוותים
כל אינטגרציה צריכה מקור אמת לכל רכיב נתונים קריטי. אם צוות תפעול המכירות יכול לעדכן פרטי חשבון ב-CRM ומחלקת הכספים יכולה לעדכן את אותם שדות במערכת הנהלת החשבונות, קונפליקט הוא בלתי נמנע, אלא אם הכללים מוגדרים.
סנכרון דו-כיווני חשוף במיוחד לכישלונות. הוא נשמע שלם, אבל מוסיף מורכבות במהירות: לולאות עדכון, התנגשויות חותמות זמן, ערכים מתחרים והתנהגות מחיקה לא חד-משמעית. במקרים רבים, זרימה חד-כיוונית מבוקרת עם כתיבה חוזרת ממוקדת בטוחה יותר וקלה יותר לתמיכה.
בעלות צריכה להתקיים גם ברמה הארגונית. ההנדסה אולי בונה את האינטגרציה, אבל התפעול הוא לרוב הבעלים של התהליך שהיא תומכת בו. צוות האבטחה עשוי לשלוט בהרשאות הגישה. ספק עשוי לשלוט ב-API עצמו. כשאף אחד לא אחראי על התוצאה מקצה לקצה, תקלות נשארות פתוחות, כי כל צוות יכול לטעון שהרכיב שלו עובד.
הטיפול בשגיאות נדחק לסוף
ממשקי API נכשלים מסיבות רגילות: מגבלות קצב, טוקנים שפג תוקפם, השבתות זמניות של שירותים, payload פגום, הפרעות רשת וחלונות תחזוקה. אינטגרציה בפרודקשן צריכה לצפות לאירועים האלה ולא להתייחס אליהם כחריגים.
מימוש חלש תופס שגיאה, רושם אותה בלוג וממשיך הלאה. מימוש ברמת פרודקשן מסווג את השגיאה ומגיב בהתאם. חלק מהבקשות צריכות לנסות שוב עם backoff. חלק צריכות להיכנס לתור לבדיקה. חלק חייבות להיעצר מיד, כי ניסיון חוזר עלול ליצור חשבוניות כפולות, משלוחים כפולים או התראות חוזרות ללקוחות.
אידמפוטנטיות היא המפתח כאן. אם תהליך עבודה מנסה שוב אחרי timeout, המערכת המקבלת לא יכולה לבצע את אותה פעולה עסקית פעמיים. זה דורש מזהים יציבים, מעקב אחר בקשות ותכנון מכוון. זה פחות גלוי מממשק משתמש, אבל זה מונע חלק מהליקויים היקרים ביותר באינטגרציות.
בעיות הארכיטקטורה שמאחורי אינטגרציות כושלות
אינטגרציות רבות נכשלות כי הן בנויות כחיבורים ישירים מנקודה לנקודה עם יותר מדי לוגיקה נסתרת. ה-CRM קורא ל-ERP, ה-ERP מפעיל פלטפורמת מיילים, וכלי אוטומציה נפרד כותב בחזרה ל-CRM. זה אולי עובד בהתחלה. עם הזמן, העסק כבר לא יכול לראות בקלות היכן רשומה השתנתה, למה תהליך נעצר או איזה חיבור צריך לשנות כשהדרישות משתנות.
ארכיטקטורה טובה יותר מפרידה בין תזמור תהליכי העבודה לבין מחברים ייעודיים לכל מערכת. המחבר מטפל באימות, בפורמטים של ה-API, ב-pagination, במגבלות קצב ובהתנהגות הייחודית לכל ספק. שכבת התזמור מחילה כללים עסקיים, מתאמת שלבים, עוקבת אחר תוצאות ומנתבת חריגים. ההפרדה הזו מקלה להחליף ספק, להוסיף שלב אישור או לעשות שימוש חוזר באותם נתונים בכמה תהליכי עבודה.
אין זה אומר שכל חברה צריכה פלטפורמת אינטגרציה גדולה. הגישה הנכונה תלויה בהיקף הטרנזקציות, בקריטיות התהליך, ברגישות הנתונים ובקצב השינוי הצפוי. אינטגרציה מתוזמנת קלה עשויה להספיק למשימת דיווח לילית. תהליכי הזמנות, תשלומים או ציות בזמן אמת דורשים בקרות חזקות יותר.
אבטחה וציות מגיעים מאוחר מדי
פרטי גישה הם לרוב הדרך המהירה ביותר להפוך הוכחת היתכנות לסיכון בסביבת הייצור. מפתחות API מקודדים בקוד, חשבונות שירות משותפים, הרשאות רחבות מדי וטוקנים ללא ניטור יוצרים חשיפה מיותרת. אם אינטגרציה יכולה לקרוא או לכתוב מידע רגיש של לקוחות, מידע פיננסי או מידע רפואי, בקרות הגישה חייבות להיות מתוכננות מההתחלה.
אותו הדבר נכון לגבי יכולת הביקורת. תהליכים מפוקחים או רגישים מבחינת ציות צריכים להראות אילו נתונים עברו, מי או מה יזם את הפעולה, אילו כללים הוחלו והאם אדם אישר חריגה. הלוגים צריכים לשרת חקירה בלי לחשוף מידע סודי שלא לצורך.
אבטחה עשויה להוסיף מאמץ לפיתוח, במיוחד כשמעורבים כמה ספקים, ספקי זהות וסיווגי נתונים. אבל הוספה שלה בדיעבד, אחרי הפריסה, היא בדרך כלל איטית יותר, משבשת יותר ויקרה יותר מתכנון מראש של גישה בהרשאות מינימליות ויכולת מעקב.
הניטור מודד תשתית, לא תוצאות עסקיות
דשבורד שמראה ש-endpoint של API החזיר קוד סטטוס 200 אינו מספיק. האינטגרציה עשויה להיות זמינה מבחינה טכנית ועדיין לא להפיק את התוצאה העסקית המבוקשת. למשל, רשומות עשויות להגיע אבל להידחות על ידי כללי ולידציה, או שהזמנות עשויות להסתנכרן בלי שורות הפריטים הנדרשות.
ניטור אפקטיבי כולל אותות טכניים ותפעוליים. הצוותים צריכים לדעת אם בקשות נכשלות, מאטות או מתקרבות למגבלות הקצב. הם צריכים לדעת גם אם רשומות תקועות, אם כמות החריגים עולה, אם עיכוב הסנכרון גדל או אם אירועים עסקיים צפויים הפסיקו להגיע.
התראות צריכות בעלים ו-runbooks מעשיים. אם תהליך קריטי נכשל ב-2:00 לפנות בוקר, הצוות האחראי צריך להיות מסוגל לזהות את הרשומות שנפגעו, לקבוע אם ניסיון חוזר בטוח ולהחזיר את העיבוד לפעולה בלי לשחזר ידנית כל טרנזקציה.
איך בונים אינטגרציות שממשיכות לעבוד
אינטגרציות אמינות מתחילות בשלב האפיון (discovery), לא ב-endpoints. לפני הפיתוח, הגדירו את התהליך במונחים תפעוליים: האירוע המפעיל, מערכות מקור האמת, הנתונים הנדרשים, ההמרות, האישורים, מסלולי הכשל והתוצאה המדידה. כך נחשפים פערים מוקדם, כשעדיין זול לפתור אותם.
לאחר מכן, בנו לשינוי מבוקר. ממשקי API מתפתחים, כללים עסקיים משתנים ומערכות מוחלפות. נהלו גרסאות לממשקים היכן שאפשר, בודדו לוגיקה ייחודית לספק, תעדו חוזי נתונים ובדקו מול תרחישים מציאותיים. כללו אירועים כפולים, עדכונים שמגיעים שלא לפי הסדר, שדות חסרים, כשלי הרשאות, השלמה חלקית והתאוששות אחרי השבתה.
השקה מדורגת בסביבת הייצור היא בדרך כלל הפשרה הנכונה. התחילו בתהליך מוגבל, בקבוצת משתמשים מוגדרת או בחלק מהרשומות. עקבו אחר התוצאות, בחנו את החריגים וודאו שהצוותים העסקיים מסוגלים להפעיל את התהליך לפני שמגדילים את ההיקף. זה לא היסוס. כך צוותים מגנים על פעילות קריטית תוך כדי התקדמות מהירה.
ב-Invatechs, עבודת אינטגרציה מטופלת כפיתוח תוכנה לסביבת ייצור, לא כפרויקט חד-פעמי של מחבר. המטרה היא אוטומציה מוחשית שעומדת בנתונים אמיתיים, במשתמשים אמיתיים, בשינויים אצל ספקים ובדרישות האחריותיות של העסק.
השאלה המועילה אינה אם שתי מערכות יכולות להחליף נתונים. רובן יכולות. שאלו אם התהליך עדיין יהיה נכון כשהנתונים מבולגנים, ה-API לא זמין, כלל משתנה ולקוח צריך תשובה עכשיו. תכננו לרגע הזה, והאינטגרציה תהפוך לנכס תפעולי ולא למקור נוסף לעבודה ידנית.