תיבת דואר משותפת שמכילה חשבוניות, חוזים, בקשות, טפסים רפואיים וראיות תומכות היא לא בעיית מסמכים. היא צוואר בקבוק תפעולי. צוותים מאבדים זמן על פתיחת קבצים, זיהוי סוגי מסמכים, איתור עמודים חסרים וניתוב עבודה למערכת הנכונה. כדי לבנות מסווגי מסמכים מבוססי AI שמייצרים ערך מדיד, חברות צריכות יותר ממודל שמתייג קובצי PDF. הן צריכות תהליך עבודה בייצור שמתמודד עם קלט לא מושלם, מתחבר למערכות העסקיות ויודע מתי לערב אדם.
ההבדל חשוב. הוכחת היתכנות עשויה לזהות נכון כמה קטגוריות מסמכים בסט דוגמאות נקי. מסווג בייצור חייב לעבוד כשהסריקות עקומות, ספקים משנים תבניות, קבצים מגיעים כקבצים מצורפים למייל ותוצאה ברמת ביטחון נמוכה עלולה לעכב תשלום, חיתום, טיפול בתביעות או בדיקת ציות.
התחילו מההחלטה, לא מהמסמך
השאלה הראשונה היא לא "באיזה מודל AI להשתמש?". היא "איזו החלטה נעשית מהירה או מדויקת יותר כשסוג המסמך ידוע?"
בתשלומים לספקים, הסיווג יכול לזהות חשבוניות, הודעות זיכוי, הזמנות רכש ותעודות משלוח לפני חילוץ הנתונים והרישום ב-ERP. בביטוח, הוא יכול להפריד בין הודעות על נזק, דוחות משטרה, הערכות, רשומות רפואיות והתכתבויות, כך שכל פריט ייכנס לתהליך התביעות הנכון. בהלוואות, הסיווג יכול להבחין בין דפי חשבון בנק, דוחות מס, תלושי שכר, מסמכי זיהוי ונספחים תומכים לפני בדיקת תיק החיתום.
הגישה שמתחילה מההחלטה מונעת דפוס כשל נפוץ: יצירת טקסונומיה רחבה שהיא מעניינת אבל חסרת תועלת תפעולית. מסווג צריך להחזיר קטגוריות שמפעילות צעד הבא ברור. זה יכול להיות ניתוב קובץ לתור, בחירת סכמת חילוץ, בקשת מסמך חסר, החלת מדיניות שמירת מידע או פתיחת תיק ב-CRM.
הגדירו את המחיר של כל שגיאה לפני תחילת הפיתוח. סיווג שגוי של חוברת שיווקית כחוזה עשוי להיות בלתי מזיק. סיווג שגוי של טופס מס כדף חשבון בנק יכול ליצור שגיאות במורד הזרם. חלק מהקטגוריות דורשות ספי אוטומציה גבוהים; אחרות יכולות לסבול סף נמוך יותר עם אימות מאוחר יותר. התכנון הנכון תלוי בסיכון, בנפח, בשונות המסמכים ובזמינות של בודקים אנושיים.
הארכיטקטורה שמאחורי מסווגי מסמכים מבוססי AI
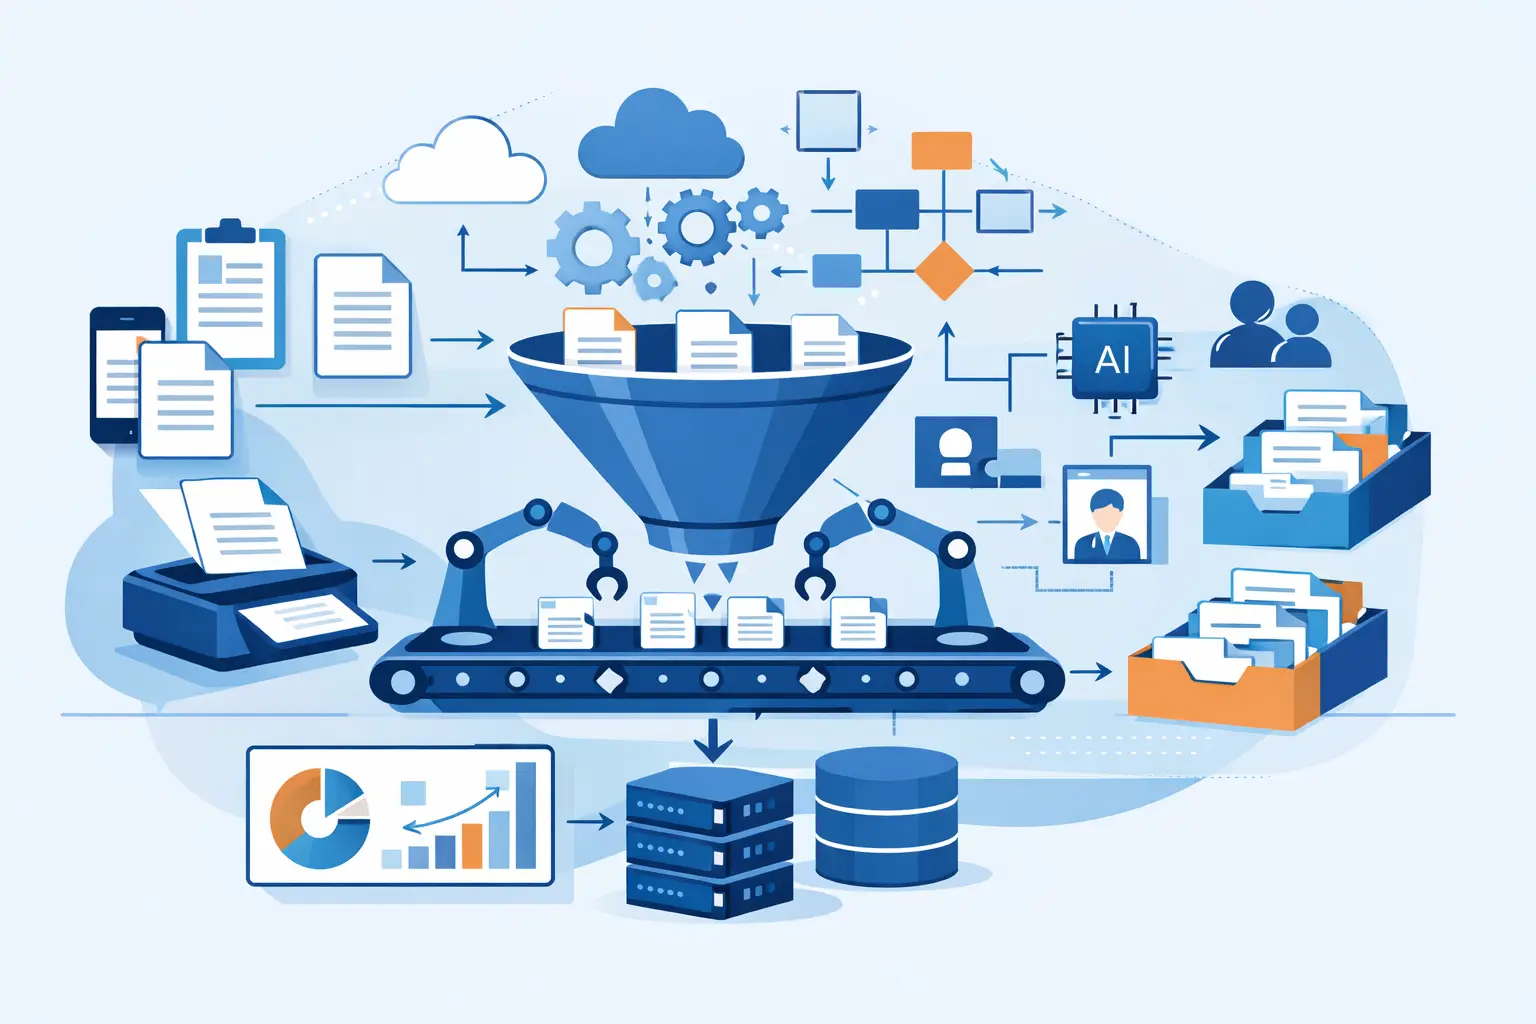
פתרון אמין הוא צנרת עיבוד, לא פרומפט יחיד או קריאה אחת למודל. הצנרת מתחילה בקליטה, שבה קבצים נכנסים דרך מייל, פורטלי העלאה מאובטחים, סורקים, APIs, אחסון ענן או אפליקציות עסקיות קיימות. כל קובץ צריך מזהה ייחודי, רשומת מקור, חותמת זמן, בקרות גישה ומסלול ביקורת לפני שמתחיל עיבוד ה-AI.
לאחר מכן מגיעה הכנת המסמך. זה כולל לעתים קרובות אימות קבצים, סריקת וירוסים, פיצול עמודים, נרמול תמונה, תיקון כיוון וזיהוי תווים אופטי (OCR). קובצי PDF מקוריים עשויים כבר להכיל טקסט שמיש, בעוד שמסמכים סרוקים דורשים OCR. איכות התמונה משפיעה ישירות על ביצועי הסיווג, ולכן העיבוד המקדים הוא שאלה הנדסית, לא מחשבה שנייה.
לאחר מכן המסווג קובע מהו המסמך. בהתאם לתרחיש, הוא יכול להשתמש בטקסט, בפריסה החזותית, במטא-דאטה או בשלושתם. דף חשבון בנק וחשבונית יכולים להכיל מילים ומספרים דומים, אבל הפריסות, הכותרות, מבני הטבלאות והדפוסים החוזרים שלהם שונים. גישות מולטימודליות יכולות לשפר את התוצאות כשהמבנה החזותי משמעותי. מודלים ממוקדי טקסט עשויים להספיק כשתבניות המסמכים עקביות יחסית ופלט ה-OCR אמין.
הסיווג צריך להזין שכבת תזמור שמחילה כללים עסקיים. חשבונית ברמת ביטחון גבוהה יכולה לעבור לחילוץ ולהתאמה. מסמך ברמת ביטחון נמוכה יכול להיכנס לתור בדיקה. קובץ שמכיל כמה סוגי מסמכים עשוי להתפצל לרשומות נפרדות. מסמך שנראה שמכיל מידע רגיש עשוי לדרוש ניתוב מוגבל או בדיקת מדיניות לפני המשך העיבוד.
לבסוף, התהליך כותב את התוצאות בחזרה למערכות שבהן העבודה מתבצעת. זה יכול לכלול ERP, CRM, פלטפורמת תביעות, מערכת לניהול מסמכים, פלטפורמת תמיכה, מחסן נתונים או אפליקציה פנימית לניהול תיקים. בלי האינטגרציה הזו, הצוותים עדיין מעתיקים תוצאות ידנית, והאוטומציה נעצרת לפני שהיא מממשת את התיק העסקי שלה.
סיווג וחילוץ הם משימות שונות
צוותים מערבבים לעתים קרובות בין המושגים, אבל הם פותרים בעיות שונות. סיווג עונה על השאלה "מהו המסמך הזה?". חילוץ עונה על השאלה "אילו נתונים הוא מכיל?". תהליך ניתוב עשוי להזדקק לסיווג בלבד. תהליך עיבוד חשבוניות צריך בדרך כלל גם סיווג וגם חילוץ, ואחריהם אימות מול הזמנת רכש או קובץ ספקים.
ההפרדה ביניהם מקלה על בדיקת המערכת ועל שיפורה. מסווג יכול להיות מדויק בזמן שמודל חילוץ מתקשה עם תבנית חדשה. לחלופין, שדות שחולצו עשויים לחשוף שהמסמך שויך לקטגוריה הלא נכונה. מערכות בייצור צריכות לאפשר ניטור עצמאי של כל אחד מהרכיבים.
בנו טקסונומיה שהתפעול יכול לתחזק
תוויות המסמכים חייבות לשקף את השפה של העסק. אם צוות התפעול קורא לקובץ "אישור מסירה", זו צריכה להיות קטגוריה או תווית ממופה ומובנת, ולא תווית מודל מופשטת שדורשת מדען נתונים כדי לפרש אותה.
שמרו על הטקסונומיה הראשונה צרה מספיק כדי לתמוך בהחלטות ברורות. היקף התחלתי שימושי יכול לכסות את סוגי המסמכים שאחראים לרוב הנפח הנכנס, המגעים הידניים או העיכובים בעיבוד. קטגוריות נדירות יכולות להיות מנותבות ל"אחר" או לבדיקה אנושית עד שיהיו מספיק נתונים כדי להצדיק אוטומציה.
איכות התיוג חשובה יותר מסט אימון גדול אבל לא עקבי. קבעו הנחיות תיוג כתובות למקרי קצה. לדוגמה, החליטו אם חשבונית ותעודת משלוח משולבות הן קטגוריה אחת, שתי קטגוריות או חבילת מסמכים מרובה. החליטו איך לתייג חוזים מתוקנים, בקשות חלקיות, קבצים כפולים וסריקות לא קריאות. ההחלטות האלה הופכות לחלק מהמודל התפעולי.
השתמשו במסמכים היסטוריים אמיתיים היכן שמותר, עם השחרה מתאימה, בקרות גישה וכללי שמירת מידע. נתוני דוגמה כמעט אף פעם לא מייצגים את הקלט המבולגן שמופיע בייצור. סט האימון וההערכה צריך לכלול מסמכים מספקים, לקוחות, אזורים גאוגרפיים, איכויות סריקה ותקופות זמן שונים.
תכננו לרמות ביטחון, לחריגים ולבדיקה אנושית
אף תהליך מסמכים רציני לא צריך להניח שכל חיזוי נכון. ספי ביטחון הם נקודת הבקרה המעשית בין אוטומציה לבדיקה. הסף צריך להשתנות לפי סוג המסמך וההשלכה במורד הזרם.
במשימת ניתוב בסיכון נמוך, מסווג יכול לעבד אוטומטית חיזויים מעל סף מוסכם ולשלוח את השאר לתור בדיקה. ברשומות רגישות מבחינת ציות או במסמכים שמפעילים פעולה פיננסית, הסף צריך להיות מחמיר יותר ועשוי לדרוש בדיקות משניות. ציון ביטחון של מודל לבדו אינו מדיניות עסקית. הוא חייב להשתלב עם סוג המסמך, המקור, בדיקות השלמות והסיכון בתהליך.
חוויית הבדיקה חשובה לא פחות מהמודל. הבודקים צריכים לראות את הקובץ המקורי, את הקטגוריה החזויה, את רמת הביטחון, את האותות הרלוונטיים שחולצו ודרך פשוטה לתקן את התוצאה. התיקונים שלהם צריכים להיאסף כמשוב מובנה, לא להיקבר בהערות. כך נוצר סט נתונים אמין לאימון מחדש, ואפשר לזהות אם הכשלים נובעים מה-OCR, מעמימות בטקסונומיה, משינויי תבניות של ספקים או מסחיפת מודל.
תהליך חריגים טוב גם מונע כשלים שקטים. אם ה-OCR מחזיר מעט טקסט קריא, אם הקובץ מוגן בסיסמה, אם ה-PDF פגום או אם המסווג מחזיר קטגוריה שאינה נתמכת, המערכת צריכה ליצור פעולה גלויה ולא להשאיר את המסמך במצב לא מוגדר.
אבטחה וציות חייבים לעצב את הבנייה
סיווג מסמכים כרוך לעתים קרובות במידע אישי מזהה, נתונים פיננסיים, מידע רפואי, חוזים ורשומות עסקיות חסויות. אי אפשר להוסיף אבטחה אחרי שהפיילוט מצליח.
ארכיטקטורת הייצור צריכה לאכוף גישה בהרשאה מינימלית, הצפנה בתעבורה ובמנוחה, הפרדת סביבות, ניהול סודות מאובטח ותיעוד מפורט של הגישה לקבצים ותוצאות הסיווג. מדיניות שמירת המידע והמחיקה צריכה להתאים לדרישות המשפטיות והתפעוליות של הארגון. היכן שחלות חובות רגולטוריות, התהליך צריך לשמר יכולת מעקב: מה התקבל, איך זה עובד, איזה סיווג הופק, מי דרס אותו ואיזו מערכת קיבלה את התוצאה.
גם בחירת המודל והספק תלויה בדרישות האלה. ארגונים מסוימים יכולים להשתמש בשירותי AI מנוהלים בתוך סביבות ענן מאושרות. אחרים צריכים דפוסי פריסה פרטיים, טיפול מוגבל בנתונים או בקרות אזוריות ספציפיות. אין תשובה אחת לכולם. הארכיטקטורה חייבת להתאים לסיווג הנתונים ולעמדת הציות של העסק.
מדדו את התוצאה, לא רק את דיוק המודל
דיוק הוא הכרחי, אבל הוא לא מוכיח ערך תפעולי. מודל יכול לקבל ציון טוב בבדיקות ולספק השפעה מוגבלת אם התוצאות לא משולבות בתהליך או אם הבודקים משקיעים זמן רב מדי בפתרון חריגים.
עקבו אחר דיוק הסיווג לפי קטגוריה, אבל נטרו גם את שיעור האוטומציה, שיעור החריגים, זמן הטיפול הממוצע, עבודה חוזרת, גיל התורים ואחוז המסמכים שמגיעים למערכת היעד במורד הזרם ללא התערבות ידנית. בתהליכים פיננסיים, מדדו זמן מחזור ועלות למסמך. בחיתום או בתביעות, מדדו זמן טיפול וצמצום הצבר. המדדים האלה חושפים אם הפתרון מספק אוטומציה מוחשית ולא הייפ AI כללי.
בצעו את ההטמעה בשלבים. התחילו בסט מסמכים תחום ובקבוצת משתמשים מבוקרת. הפעילו במצב צל כשהסיכון גבוה: תנו למערכת לסווג מסמכים בזמן שאנשים ממשיכים בתהליכים הקיימים, ואז השוו את התוצאות. ברגע שהביצועים והטיפול בחריגים הוכחו, אפשרו ניתוב אוטומטי לקטגוריות בסיכון הנמוך ביותר קודם. הרחיבו רק כשתהליך העבודה, האינטגרציות ובקרות הממשל עומדים בנפח אמיתי.
הפכו את הסיווג לתהליך עבודה שעובד
תוכניות ה-AI למסמכים החזקות ביותר לא מתייחסות לסיווג כיכולת מבודדת. הן משתמשות בו כשכבת ההחלטה הראשונה במערכת רחבה יותר: קליטה, אימות, חילוץ, ניתוב, אישורים ודיווח. שם הרווחים התפעוליים מצטברים.
Invatechs ניגשת לפרויקטים האלה כיישומי תוכנה ותהליכי עבודה, מחברת את פלט ה-AI למערכות שהצוותים כבר משתמשים בהן ובונה את הבקרות הנדרשות לייצור. המטרה היא לא להראות שמודל מזהה מסמך. היא לצמצם עבודה ידנית בלי להכניס אי-ודאות חדשה לתהליך קריטי.
התחילו בהחלטת מסמך אחת שהיא תכופה, יקרה ומדידה. כשההחלטה הזו מחוברת לתהליך העבודה הנכון, מסווג הופך ליותר מיכולת AI. הוא הופך לחלק אמין מהאופן שבו העסק מקדם עבודה.